Índice do artigofaltam 13 min de leitura
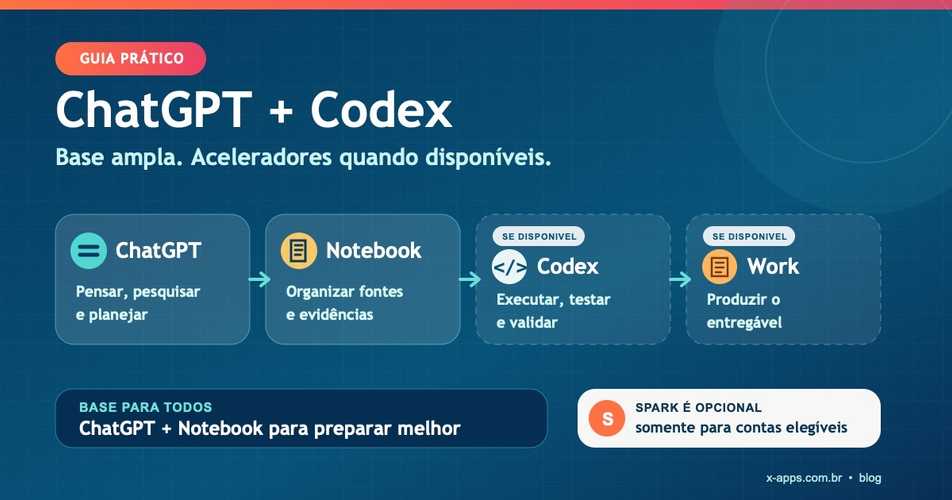
A regra de bolso para qualquer plano: use o ChatGPT para pensar e o Gemini Notebook para organizar fontes. Se sua assinatura incluir Codex, use-o para executar e validar software. Work entra como acelerador opcional somente quando estiver disponível na sua conta.
Ter acesso aos modelos mais capazes não significa que você deva usar o modo mais caro ou o maior esforço de raciocínio em toda tarefa. Na prática, a melhor forma de aproveitar uma assinatura do ChatGPT é encaminhar cada trabalho para o ambiente certo e reduzir a ambiguidade antes de iniciar a execução.
Essa disciplina melhora a qualidade e preserva a franquia incluída no plano. Ela também reduz o custo oculto mais comum em ferramentas de IA: gastar várias interações corrigindo direção, reexplicando contexto ou desfazendo uma implementação que começou cedo demais.
Este guia foi publicado em 21 de julho de 2026 e revisado em 10 de novembro de 2026. Nessa revisão saiu o GPT-5.3-Codex-Spark, aposentado pela OpenAI em 14 de setembro de 2026, e entrou a linha de modelos que a OpenAI recomenda hoje para Codex e Work. Recursos, modelos, limites e elegibilidade podem mudar conforme plano, região, workspace e disponibilidade gradual. Para consumo e saldo, considere o painel Codex Settings → Usage da sua própria conta como fonte de verdade.
O fluxo abaixo tem duas camadas. A primeira combina ChatGPT e Gemini Notebook e atende o público mais amplo, inclusive quem ainda não tem o Codex liberado na conta (no Free e no Go ele chega aos poucos, só no app desktop). A segunda acrescenta Codex e Work quando esses recursos fizerem parte do plano ou estiverem habilitados no workspace.
Resumo rápido: qual ambiente usar?
| Se você precisa... | Comece por... | Por quê |
|---|---|---|
| Tirar uma dúvida, comparar alternativas ou organizar uma ideia | Chat | Evita iniciar uma execução antes de o problema estar claro |
| Estudar muitas fontes antes de decidir | Gemini Notebook ou RAG | Filtra e organiza o conhecimento antes da execução |
| Modificar arquivos, executar comandos, testar e validar software | Codex, quando incluído no plano | Trabalha no contexto real do repositório |
| Fazer uma pequena alteração interativa em código | Codex com GPT-6 Luna | É o modelo mais eficiente da linha atual e serve para programação focada |
| Produzir documento, planilha ou apresentação | Work, quando disponível, ou Chat | Separa a pesquisa do entregável final |
| Repetir regras em todo trabalho de um projeto | AGENTS.md | Carrega instruções persistentes automaticamente |
| Repetir um procedimento com etapas e critérios próprios | Skill | Transforma um bom processo em workflow reutilizável |
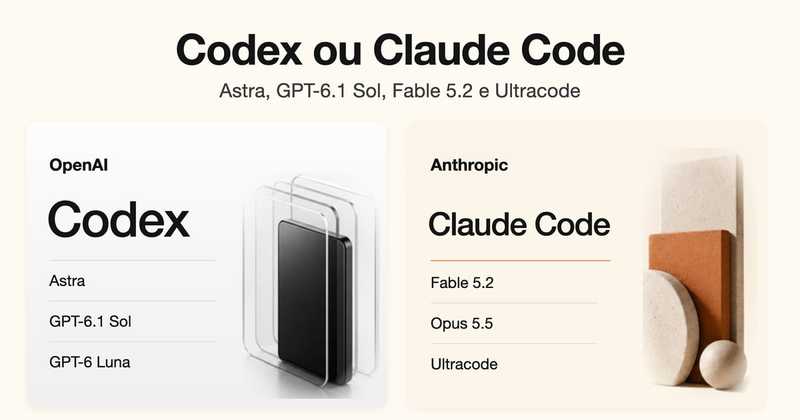
A própria OpenAI diferencia Chat, Work e Codex: Chat atende conversas e perguntas cotidianas; Work executa trabalhos longos e cria entregáveis; Codex permanece especializado em desenvolvimento e trabalho técnico.
Chat, Gemini Notebook, Work e Codex não são a mesma coisa
O primeiro passo para economizar é parar de tratar todas as superfícies como se fossem apenas atalhos para o mesmo chat.
Chat: pensar, pesquisar e preparar
Use o Chat para:
- transformar uma ideia imprecisa em objetivo;
- comparar abordagens;
- identificar riscos e premissas;
- preparar critérios de aceite;
- revisar um prompt antes da execução;
- resumir contexto que será enviado a outra ferramenta.
O Chat comum continua sujeito aos limites do modelo e do plano escolhidos. A diferença é que a documentação de uso agêntico cita Codex, Work, ChatGPT para Excel e Workspace Agents como recursos que compartilham essa estrutura quando disponíveis. Portanto, não trate a barra de uso agêntico como um medidor universal de toda conversa no ChatGPT; confira sempre o painel da conta. (Uso do Codex no plano ChatGPT)
Work: executar uma pesquisa e entregar o arquivo final
Use Work quando a solicitação não termina em uma resposta, mas em um entregável: relatório, apresentação, planilha, documento, análise recorrente ou Site.
Uma pergunta como “quais tópicos devem entrar neste relatório?” pode começar no Chat. Já “analise as fontes, monte as tabelas, produza os gráficos e entregue o documento” é um trabalho adequado para o Work.
Codex: agir no ambiente técnico real
Use Codex quando a tarefa exigir acesso a repositório, arquivos, terminal, testes, documentação e ferramentas. É nesse contexto que ele consegue não apenas sugerir código, mas implementar e verificar o resultado.
Na página de preços do Codex consultada em 10 de novembro de 2026, até os planos Free e Go aparecem com o GPT-6 Luna no app desktop, em velocidade padrão e sujeito a liberação gradual. Plus inclui Codex na web, no CLI, na extensão de IDE e no iOS. A mesma página informa que Work e Codex compartilham o uso do plano. (Preços do Codex)
Gemini Notebook: organizar muitas fontes antes de executar
O Gemini Notebook, anteriormente conhecido como NotebookLM, é útil para reunir documentos, páginas, transcrições e outras fontes antes de pedir uma análise ou implementação. Ele não substitui ChatGPT ou Codex: sua função principal é reduzir o volume de contexto e manter as respostas vinculadas ao material selecionado.
Esse é o caminho mais abrangente para qualquer plano: organize as fontes no notebook, produza um resumo verificável e leve somente o contexto necessário ao ChatGPT. Quando houver uma tarefa de programação, o briefing resultante pode ser entregue ao Codex disponível no plano ou a uma equipe técnica.
Codex-Spark: aposentado em setembro de 2026
O GPT-5.3-Codex-Spark foi um modelo de pesquisa voltado à programação quase em tempo real. Durante o preview, tinha limites próprios e ficou restrito a usuários Pro elegíveis. A OpenAI o aposentou em 14 de setembro de 2026: ele não está mais disponível no app desktop do ChatGPT, no Codex CLI nem na extensão de IDE. Se alguma configuração salva, agente personalizado ou script ainda seleciona gpt-5.3-codex-spark, troque por um modelo disponível. (Modelos do Codex)
O princípio que o Spark servia continua valendo: para uma mudança pequena, delimite o escopo, peça o menor diff possível e exija os testes relacionados. Hoje isso se faz no Codex com o GPT-6 Luna, o modelo mais eficiente da linha atual. Se a pressa for o problema, o Fast mode acelera os modelos suportados, mas consome a franquia incluída a 2,5 vezes a taxa padrão; num guia sobre não gastar mais, ele é exceção consciente, não padrão. (Velocidade no Codex)
Se o Codex ainda não estiver disponível na sua conta, use ChatGPT para preparar o briefing e encaminhe a execução para o ambiente de desenvolvimento ou para a equipe responsável.
A estratégia mais econômica: pensar antes de executar
O desperdício começa quando uma tarefa ainda ambígua entra diretamente no Codex ou no Work.
Perguntas como estas devem ser respondidas primeiro:
- Qual problema precisa mudar no produto?
- O que está dentro e fora do escopo?
- Quais arquivos, módulos ou fontes são relevantes?
- Que comportamento existente precisa ser preservado?
- Quais riscos e casos extremos devem ser testados?
- O que precisa ser verdadeiro para considerar a tarefa concluída?
A documentação de boas práticas do Codex recomenda quatro elementos em um bom pedido: objetivo, contexto, restrições e definição de concluído.
Prompt para transformar uma ideia em briefing de implementação
Transforme a demanda abaixo em um briefing de implementação pronto
para ser entregue ao Codex.

Estruture a resposta em:

1. Objetivo
2. Contexto necessário
3. Escopo incluído
4. Escopo não incluído
5. Arquivos ou módulos provavelmente envolvidos
6. Restrições técnicas
7. Riscos e casos extremos
8. Estratégia de testes
9. Critérios de aceite
10. Definição de concluído

Não implemente a solução.

Identifique ambiguidades e adote premissas razoáveis quando possível.
Produza um briefing autocontido, direto e verificável.

Demanda:
[cole a demanda]
Revise o briefing e envie ao Codex apenas a versão final. Assim, a execução começa quando a direção já está madura.
Escolha o menor modelo e esforço que resolvam com segurança
Em novembro de 2026, o Codex separa modelo e esforço de raciocínio; acima dos esforços comuns ficam Max e Ultra, para tarefas maiores. A linha que a OpenAI recomenda para Codex e Work é esta:
- GPT-6 Luna: o modelo mais eficiente, para tarefas focadas e de alto volume, como resumo, extração e programação focada.
- GPT-6.1 Terra: rápido e eficiente, para escrita clara, compreensão visual e uso do computador. A documentação o lista no app desktop, no Work na web e no Codex CLI, mas não na extensão de IDE.
- GPT-6.1 Sol: desempenho próximo do Astra a custo menor, para trabalho complexo, repetido ou longo. Na troca do GPT-5.5, aposentado do Codex em 14 de outubro de 2026, a OpenAI orienta quem está no Plus, Pro, Business, Enterprise ou Edu a escolher o GPT-6.1 Sol quando ele estiver disponível.
- Astra: o mais capaz, para os fluxos mais exigentes em código, apps e pesquisa.
Os modelos GPT-5.6 Sol, Terra e Luna, que este guia citava em julho, são a geração anterior: ainda aparecem na tabela de créditos, mas saíram da lista de recomendados. A própria OpenAI avisa que os níveis de esforço não se equivalem entre gerações, então não copie a configuração antiga para o modelo novo. (Modelos do Codex)
Os esforços são Light (no app e na IDE; Low no CLI), Medium, High, Extra High e, nos dois níveis mais altos, Max e Ultra. Light serve para tarefas rápidas e bem delimitadas; High e Extra High, para trabalho difícil com várias etapas, fontes ou trocas. Max dá mais tempo de raciocínio a uma única tarefa, e Ultra divide uma tarefa complexa entre subagentes em paralelo. A documentação resume: a maioria das tarefas não precisa de Max nem de Ultra. O GPT-6 Luna vai até Max, mas não tem Ultra.
O peso de cada modelo na franquia é muito diferente. Nas estimativas da OpenAI para o Plus, em mensagens locais a cada cinco horas, o Astra rende de 5 a 45, o GPT-6.1 Sol de 15 a 160, o GPT-6.1 Terra de 35 a 285 e o GPT-6 Luna de 350 a 3.000. A OpenAI ressalva que essas faixas não são limites fixos e que tarefas na nuvem podem consumir mais. (Preços do Codex)
| Tipo de tarefa | Configuração inicial |
|---|---|
| Renomeação, extração ou alteração mecânica | GPT-6 Luna, começando em High, como recomenda a OpenAI |
| Implementação cotidiana com requisitos claros | GPT-6.1 Sol no esforço padrão do seu cliente |
| Texto, leitura de tela ou uso do computador | GPT-6.1 Terra + Medium |
| Debugging, arquitetura ou mudança importante | GPT-6.1 Sol + High ou Extra High |
| Problema único, profundo e muito difícil | GPT-6.1 Sol + Max; Astra só se o Sol não resolver |
| Projeto grande com frentes independentes | GPT-6.1 Sol + Ultra |
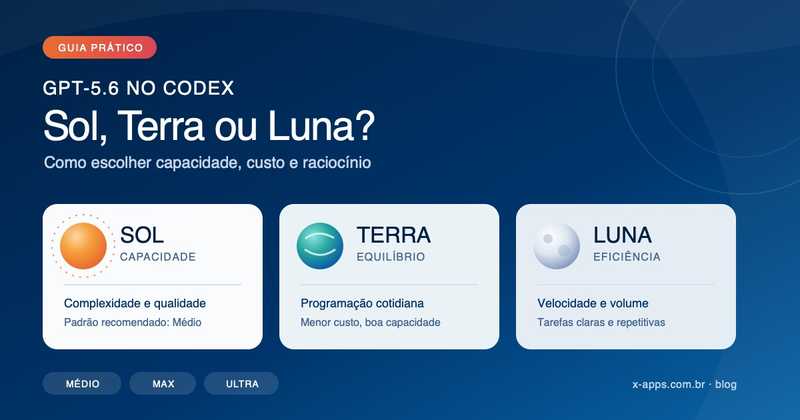
Para o contexto da geração anterior, o guia GPT-5.6 Sol, Terra ou Luna no Codex continua no ar como registro de julho de 2026.
Para iterar rápido, use um modelo leve, sem pular a validação
Um modelo leve, como o GPT-6 Luna, funciona bem em:
- pequenas correções;
- alterações localizadas;
- criação de uma função ou teste;
- ajustes de componentes;
- renomeações e conversões;
- experimentação rápida de interface;
- investigação inicial de um arquivo.
Ele é menos indicado para migrações extensas, decisões arquiteturais, mudanças em muitos serviços ou tarefas que exigem investigação longa.
Prompt curto para uma alteração pequena no Codex
Faça a menor alteração necessária para atingir o objetivo.

Não altere interfaces públicas, dependências ou arquitetura sem
necessidade comprovada.

Depois da implementação:

1. Execute os testes relacionados aos arquivos modificados.
2. Execute lint e verificação de tipos, quando disponíveis.
3. Informe os comandos executados.
4. Informe quais verificações passaram ou falharam.
5. Não considere a tarefa concluída enquanto houver erro relacionado
   à alteração.
Enquanto existiu, o Spark tinha cota separada durante o preview. Hoje a iteração rápida sai da mesma franquia do resto do trabalho, então o ganho vem de usar um modelo eficiente e um pedido bem delimitado, não de um saldo à parte. O objetivo é reduzir latência sem reduzir rigor.
Reserve o Codex completo para execução real
Codex entrega mais valor quando recebe autoridade e contexto para:
- modificar vários arquivos relacionados;
- investigar um erro no repositório;
- executar comandos e testes;
- implementar uma funcionalidade de ponta a ponta;
- preparar uma migração;
- revisar alterações e riscos;
- validar o resultado em ambiente real;
- preparar commit, push ou pull request quando solicitado.
Nesse tipo de tarefa, uma resposta teórica no Chat não substitui a implementação. O uso econômico não significa evitar o Codex; significa chegar ao Codex com a tarefa pronta para ser executada.
Use instruções personalizadas como padrão de preparação
As instruções personalizadas do ChatGPT podem definir como suas ideias devem ser organizadas antes de virarem trabalho técnico.
Por exemplo, você pode pedir que toda demanda de software seja convertida em problema, premissas, riscos, critérios de aceite e testes. Usuários Free e Go podem salvar até 1.500 caracteres; Plus, Pro, Enterprise, Business e Education, até 5.000. (Instruções personalizadas do ChatGPT)
Não misture três níveis diferentes de orientação:
| Mecanismo | Escopo correto |
|---|---|
| Instruções personalizadas | Preferências gerais do usuário em conversas futuras |
AGENTS.md | Regras persistentes de um projeto ou repositório |
| Skill | Procedimento especializado e repetível |
Detalhes de um único projeto não devem ir para instruções globais. Eles pertencem ao repositório ou a uma skill específica.
Pare de repetir regras: use AGENTS.md
Se você explica os mesmos comandos, convenções e proibições em toda tarefa, está gastando contexto para reconstruir algo que deveria ser permanente.
O Codex lê arquivos AGENTS.md antes de trabalhar. É possível manter orientação global em ~/.codex/AGENTS.md e regras específicas dentro do repositório ou de subdiretórios. Instruções mais próximas da pasta de trabalho complementam ou substituem orientações anteriores. (Como o Codex descobre AGENTS.md)
# Convenções do projeto

## Ambiente

- Use pnpm.
- Use a versão de Node.js definida no projeto.
- Não adicione dependências de produção sem justificativa.

## Implementação

- Preserve compatibilidade com a API pública.
- Não duplique lógica existente.
- Siga os padrões encontrados nos módulos adjacentes.

## Validação

- Execute testes relacionados.
- Execute lint e verificação de tipos.
- Adicione testes para novo comportamento.

## Definição de concluído

- Código implementado.
- Testes passando.
- Nenhum erro relacionado de lint ou tipagem.
- Mudanças documentadas quando necessário.
O comando /init do Codex CLI pode criar uma estrutura inicial, mas o arquivo gerado precisa ser revisado para representar o processo real da equipe.
Transforme procedimentos recorrentes em Skills
Uma Skill combina instruções com referências, recursos e scripts opcionais. O Codex começa vendo nome e descrição e carrega o SKILL.md completo quando a tarefa corresponde ao escopo. Por isso, a descrição precisa deixar claro quando usar e quando não usar. (Como criar Skills no Codex)
Use Skills para tarefas como:
- revisar migrations;
- publicar uma versão;
- validar um post;
- preparar um relatório recorrente;
- executar QA visual;
- gerar um pacote de handoff;
- operar uma integração que segue sempre o mesmo procedimento.
Prompt para revisar uma Skill antes de adotá-la
Analise a skill abaixo como uma revisão de engenharia de prompts.

Verifique:

1. Se o nome representa sua finalidade.
2. Se a descrição explica quando usar e quando não usar.
3. Se existem etapas ambíguas ou premissas ocultas.
4. Se a definição de concluído é verificável.
5. Se faltam comandos, validações ou tratamento de erro.
6. Se o procedimento deveria ser dividido em skills menores.

Depois, produza uma versão revisada do SKILL.md e proponha casos
positivos, negativos e limítrofes para testar o acionamento.
Esse é um dos maiores ganhos de longo prazo: cada erro corrigido deixa de ser apenas uma conversa e passa a melhorar as próximas execuções.
Organize muitas fontes antes de consumir execução agêntica
Quando o trabalho começa com dezenas de documentos, transcrições, manuais ou páginas, não é eficiente pedir que o agente releia tudo em cada tentativa.
O Gemini Notebook, anteriormente conhecido como NotebookLM, permite reunir fontes e conversar com esse conjunto. Na modalidade gratuita, a documentação informa 100 notebooks, até 50 fontes por notebook, 500 mil palavras por fonte, 50 consultas diárias e três resumos em áudio por dia. Esses limites são sujeitos a mudança. (Perguntas frequentes do Gemini Notebook)
Um fluxo eficiente é:
- Adicionar as fontes ao notebook.
- Identificar fatos, divergências, conceitos e referências.
- Gerar um resumo estruturado com citações.
- Conferir informações sensíveis nas fontes originais.
- Levar ao Chat somente o contexto relevante.
- Acionar Work ou Codex para produzir o resultado final.
O notebook organiza conhecimento; ele não torna toda conclusão automaticamente correta. Citações, números e decisões importantes ainda exigem conferência.
Alternativas de RAG sem uma nova assinatura
Para bases privadas ou fluxos sob controle próprio, há opções self-hosted e open source:
- AnythingLLM para conversar com documentos usando modelos locais ou provedores externos;
- Open WebUI como interface self-hosted com modelos, ferramentas e conhecimento;
- Dify para construir bases de conhecimento, pipelines de RAG e aplicações reutilizáveis.
“Sem nova assinatura” não significa custo total zero. Uma solução local pode exigir hardware, armazenamento, energia, backup, segurança e manutenção. Também não basta instalar a interface local: se o modelo, embeddings ou banco vetorial usarem um provedor em nuvem, dados e custos continuam saindo da máquina.
Para entender as decisões técnicas por trás dessa camada, veja o guia prático de RAG e os testes de regressão para prompts e RAG.
Fluxo recomendado: uma base para todos e aceleradores opcionais
1. Organize conhecimento
Use um notebook ou RAG para localizar evidências e reduzir o material ao contexto relevante.
2. Planeje no Chat
Transforme a necessidade em objetivo, contexto, restrições, testes e critérios de aceite.
3. Escolha a execução disponível
Para alterações pequenas e ciclos rápidos, use Codex com o GPT-6 Luna. Para o resto, escolha modelo e esforço proporcionais à tarefa. Sem Codex, finalize o briefing no Chat e encaminhe-o ao ambiente ou à equipe que fará a implementação.
4. Execute no Codex, quando incluído
Modifique o repositório, rode comandos e valide o comportamento real.
5. Produza entregáveis no Work ou no Chat
Use Work quando ele estiver habilitado para relatórios, documentos, planilhas, apresentações e pesquisas concluídas. Caso contrário, o Chat continua adequado para estruturar, revisar e finalizar conteúdo em formatos compatíveis com a conversa.
6. Preserve o aprendizado
Transfira convenções para AGENTS.md e procedimentos recorrentes para Skills.
O resultado é cumulativo: cada tarefa bem executada reduz o custo das seguintes.
Como evitar cobranças além da assinatura
Créditos são um complemento opcional para continuar usando recursos compatíveis depois que a franquia incluída termina. Em planos elegíveis, Codex Settings → Usage permite consultar saldo, consumo recente e opções de crédito. (Créditos flexíveis no ChatGPT)
Se o objetivo for não gastar absolutamente nada além da mensalidade:
- confira periodicamente o painel de uso;
- mantenha a recarga automática desativada;
- não compre créditos adicionais;
- reduza modelo e esforço quando a tarefa permitir;
- deixe Fast mode e Ultrafast desligados por padrão: na franquia incluída, o Fast consome 2,5 vezes a taxa padrão e o Ultrafast, 8 vezes (Preços do Codex);
- aguarde a renovação do limite quando a franquia acabar;
- não confunda limite incluído com promessa de uso ilimitado.
Em workspaces corporativos, administradores também podem definir controles de gasto e limites por usuário ou grupo. As opções variam conforme plano e configuração.
Os limites de uso do ChatGPT e do Codex estão em mudança no fim de 2026. Para o que a OpenAI anunciou sobre isso, veja o que muda no limite do ChatGPT e do Codex.
Checklist para produzir mais sem pagar mais
Antes de iniciar uma demanda, pergunte:
- É apenas uma dúvida, análise ou planejamento? Comece no Chat.
- Existem muitas fontes? Organize-as em um notebook ou RAG.
- A alteração é pequena e bem delimitada? Use o GPT-6 Luna no Codex.
- É preciso modificar arquivos e executar testes? Use Codex se estiver incluído; caso contrário, prepare o handoff no Chat.
- O resultado é um documento ou relatório completo? Use Work quando disponível ou finalize no Chat.
- Estou repetindo instruções? Registre em
AGENTS.mdou Skill. - O modelo ou esforço é maior que a tarefa exige? Reduza com segurança.
- A tarefa tem objetivo, contexto, restrições e definição de concluído? Complete antes de executar.
- A recarga automática está ativa? Desative se não aceitar custo adicional.
- O resultado foi validado? Economia sem verificação costuma virar retrabalho.
O que não fazer
- Não usar Codex apenas para perguntar “qual abordagem devo escolher?”.
- Não acionar Ultra para uma tarefa curta ou impossível de paralelizar.
- Não começar pelo Astra por hábito: ele gasta a franquia muito mais rápido que o GPT-6.1 Sol.
- Não repetir dezenas de regras do projeto em cada prompt.
- Não deixar
gpt-5.3-codex-sparkem configurações, agentes ou scripts salvos: o modelo foi aposentado em setembro de 2026. - Não tratar um modelo rápido como substituto de testes.
- Não enviar todas as fontes brutas quando um resumo verificável resolve.
- Não assumir que “local” significa privado se algum componente chama a nuvem.
- Não ativar recarga automática sem definir conscientemente um teto de gasto.
Conclusão
A produtividade não cresce porque o maior modelo foi selecionado em todas as tarefas. Ela cresce quando cada ambiente recebe o trabalho para o qual foi projetado.
O núcleo mais acessível é simples: use ChatGPT para pensar e preparar, e Gemini Notebook para organizar fontes. Quando sua conta oferecer as superfícies adicionais, use Codex para implementar e validar, Work para entregáveis completos e o GPT-6 Luna para ciclos curtos de programação. Transforme conhecimento recorrente em AGENTS.md e Skills somente quando o trabalho técnico justificar essa camada.
A melhor forma de aproveitar uma assinatura não é consumir a franquia rapidamente. É fazer cada interação produzir um resultado verificável e cada aprendizado melhorar permanentemente o processo.
Quer transformar experimentos com IA em um processo confiável?
A X-Apps ajuda empresas a desenhar fluxos de IA, integrar conhecimento, automatizar tarefas e colocar agentes em produção com segurança, governança e observabilidade.
Fontes oficiais e documentação
- ChatGPT Work and Codex - OpenAI Help Center
- Using Codex with your ChatGPT plan - OpenAI Help Center
- Using Credits for Flexible Usage in ChatGPT - OpenAI Help Center
- Models - ChatGPT Work and Codex
- Pricing - ChatGPT Work and Codex
- Speed - ChatGPT Work and Codex
- Best practices - Codex
- Custom instructions with AGENTS.md - Codex
- Build Skills - Codex
- Introducing GPT-5.3-Codex-Spark - OpenAI (registro histórico; o modelo foi aposentado em 14/09/2026)
- Perguntas frequentes do Gemini Notebook - Google
- AnythingLLM Documentation
- Open WebUI Documentation
- Dify Documentation