Índice do artigofaltam 7 min de leitura
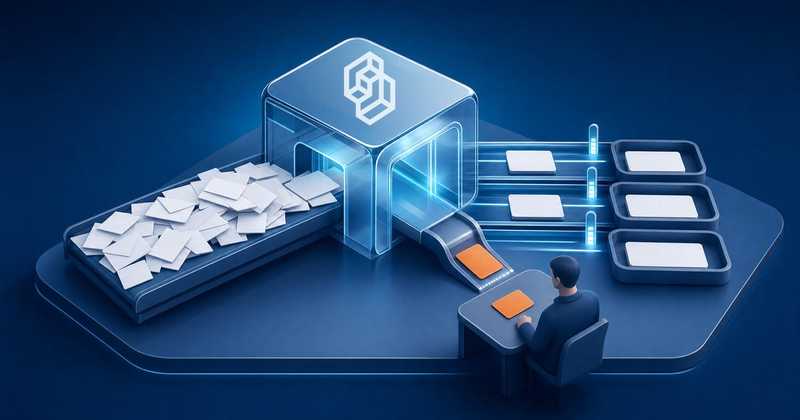
Dos sete passos que o orquestrador de agentes da Meta executa em cada pedido, seis são determinísticos e, segundo a empresa, não dependem de raciocínio de modelo. O único que depende acontece fora dele, dentro de um subagente especialista que só enxerga o próprio domínio. A Meta descreveu o desenho em 19 de outubro de 2026, num texto de três autores no blog de engenharia da empresa, e a frase que resume a decisão é deles: o orquestrador faz "zero trabalho de domínio".
A própria Meta chama de convencional o caminho oposto, que é fazer do coordenador a peça mais inteligente, e conta que começou por ele. Nós também: o que escrevemos aqui em maio vai nessa direção, e voltamos a isso mais abaixo.
O agente que sabia tudo e passou a errar em produção
O problema da Meta é chato e grande: cadastrar uma coluna de dados nova nos sistemas de recomendação. Cada coluna atravessa três repositórios, três linguagens e até seis etapas de pipeline que precisam ficar sincronizadas, e o sistema precisa saber preencher dados de mais de dez fontes diferentes, cada uma com seu padrão.
A primeira versão foi um agente único carregado com tudo: esquemas de configuração, regras de geração de código, roteamento de pipeline, validação. Segundo a Meta, funcionou em demonstração e começou a alucinar em produção. O erro tinha um padrão: o agente aplicava a convenção de nome de um subsistema em outro, ou usava o padrão de geração de código de uma fonte de dados quando estava preenchendo outra. Passado um certo volume de contexto, conhecimento a mais piorava o resultado em vez de melhorar.
A empresa também testou um segundo agente único. Ele acertava de 70% a 80% das vezes quando um engenheiro escrevia um prompt de sistema específico para cada tarefa, e de 10% a 20% sem essa ajuda. A conclusão do texto é que o problema não era de prompt, era de arquitetura.
Seis passos sem raciocínio de modelo e um com
A correção foi separar o sistema em duas camadas: um roteador determinístico e 14 subagentes, cada um com contexto isolado. O roteador segue o mesmo protocolo para qualquer pedido:
| Passo | O que acontece | Como é decidido |
|---|---|---|
| 1 | lê o arquivo de instrução do subagente certo | regra fixa |
| 2 | confere se o alvo já existe, para não duplicar | regra fixa |
| 3 | coleta do usuário os campos obrigatórios | regra fixa |
| 4 | descobre sozinho o que dá para inferir, como o tipo de repositório | regra fixa |
| 5 | passa pelo portão de confiabilidade: avisos ativos, revisores obrigatórios | regra fixa |
| 6 | delega ao subagente, com o contexto completo daquela tarefa | raciocínio de modelo, dentro do subagente |
| 7 | trata o resultado, mostra o erro ou confirma o sucesso | regra fixa |
O que a tabela mostra é onde a Meta pôs a fronteira. "Qual subagente cuida disto?" virou decisão de roteamento, que o orquestrador resolve classificando a intenção e coletando os campos; na parte de recomendações, a Meta acrescenta o casamento de palavra-chave. Raciocínio só existe no passo 6, e num lugar onde o subagente de uma fonte de dados nunca vê os padrões de outra. É assim que a Meta explica o ganho: o subagente que nunca viu o padrão de outra fonte não tem de onde tirá-lo por engano.
O resto do desenho segue a mesma lógica. A ordem das etapas fica em modelos de fluxo, máquinas de estado que limitam o que o modelo pode escolher: um para cadastro de coluna, um para cadastro de evento, um para migração de pipeline. Quando a migração apareceu como caso novo, ninguém escreveu agente novo: escreveram um modelo de fluxo que sequencia os mesmos 14 subagentes em outra ordem. Os subagentes têm todos a mesma estrutura (fontes de conhecimento, o que o roteador precisa coletar antes, passo a passo, onde procurar padrões no código, mapa de erro para solução), e o conhecimento mora em mais de 25 arquivos carregados na hora da execução, não embutido no orquestrador. O orquestrador inteiro tem 1.300 linhas e atende mais de 20 fluxos.
O que os números dizem, e o que a Meta não publicou
O resultado que a Meta destaca é o preparo de configuração de uma coluna nova: de três a quatro dias à mão, cerca de um dia com o sistema anterior guiado por configuração, menos de uma hora com o orquestrador fino. É o preparo de configuração, não a coluna inteira chegando a produção, e é a empresa medindo o próprio sistema.
O segundo número é mais útil do que parece: cerca de dois terços das mudanças que o sistema faz entram sem edição humana significativa. Lido pelo outro lado, perto de 10 em cada 30 mudanças recebem edição significativa ou nem chegam a entrar, e a Meta não separa os dois casos nem diz quantas passam por revisor. O desenho reduz o trabalho de correção manual; ele não o elimina, e a própria Meta, ao falar de melhoria automática do conhecimento dos subagentes, diz que estuda o caminho e que a revisão humana fica como portão.
O que ficou fora do texto: quanto o sistema gasta em tokens, a latência, a taxa de erro em produção, quantas colunas já passaram por ele e quantas pessoas o mantêm. Para quem quer estimar o custo de copiar o desenho, a conta não fecha com o que foi publicado. Sabe-se o tamanho do roteador, o número de arquivos de conhecimento que alguém precisa manter atualizados e que cada um costuma ter alguns milhares de tokens; o custo de execução não está no texto.
Para quem este desenho não vale
O caso da Meta tem uma forma que nem toda tarefa tem. Cadastrar coluna é um processo repetitivo, tipado, com esquema conhecido e etapas fixas. É por isso que dá para rotear por regra fixa: o espaço de pedidos é limitado e conhecido de antemão. O padrão serve a processos com essa forma e perde o sentido em tarefa exploratória, em que ninguém sabe de antemão quais etapas vão existir.
Há dois contrapontos públicos bons, e o primeiro vai direto contra o desenho. Walden Yan, da Cognition, defendeu em junho de 2025 que o primeiro princípio de um agente confiável é compartilhar o contexto inteiro, e mostrou por quê com um clone de Flappy Bird: um subagente fez o cenário, outro fez o pássaro, e as partes não combinaram. Mesmo quando cada subagente recebeu o contexto dos anteriores, pássaro e cenário saíram em estilos visuais diferentes, porque um não via o trabalho do outro e cada um carregava decisões implícitas que ninguém tinha fixado. A Meta faz o oposto de propósito: escreve que nenhum subagente vê o quadro inteiro e que isso é a vantagem, não o defeito.
No mesmo mês a Anthropic publicou como montou o sistema de pesquisa com vários agentes: com Claude Opus 4 coordenando e Claude Sonnet 4 nos subagentes, ele superou o Opus 4 sozinho em 90,2% na avaliação interna de pesquisa, mas agentes gastam cerca de 4 vezes os tokens de um chat e o sistema multiagente, cerca de 15 vezes. Pela nossa conta, perto de quatro vezes o que um agente único gasta. A mesma Anthropic escreveu que domínios em que todos os agentes precisam do mesmo contexto, ou em que há muita dependência entre eles, ainda não combinam com multiagente, e deu a programação como exemplo. Etapas que precisam ficar sincronizadas, como as da Meta, estão perto dessa descrição.
Nossa leitura é que o desenho da Meta contorna o problema da Cognition sem desmenti-lo. O roteador coleta os campos obrigatórios antes de delegar, e os subagentes entram um de cada vez, na ordem do modelo de fluxo, então sobra menos decisão implícita para divergir. Menos não é nenhuma: o relato não diz como uma escolha feita na etapa de esquema chega à etapa de preenchimento, e é nesse ponto que o alerta da Cognition continua valendo. Em tarefa aberta, sem esse preparo, ele vale inteiro.
E a autocorreção prometida. No pilar sobre orquestrar agentes de IA, a matriz de decisão já indicava workflow determinístico para processo repetitivo. O erro foi outro: ao descrever o orquestrador de vários agentes, escrevemos que ele "interpreta a demanda" e "decide quais sub-agents devem atuar", sem separar roteamento de raciocínio. O relato da Meta mostra essa separação funcionando dentro de um sistema multiagente: quem escolhe o especialista é regra fixa, e o modelo raciocina só dentro do especialista.
Na rotina que publica este blog chegamos a uma parte desse lugar. Os portões que barram uma publicação, como o validador de post, a conferência dos commits e a checagem dos números, são scripts, e o modelo escreve e revisa o texto. A ordem das etapas, porém, ainda está em instruções que o próprio modelo segue, que é justamente a parte que o relato da Meta manda tirar dele.
A pergunta para a próxima revisão do seu agente
A tradução para uma empresa brasileira não passa por escala de big tech. Passa pelo tipo de processo. Cadastro de produto no ERP, abertura de cliente com validação fiscal, integração de pedido entre loja e estoque: são processos repetitivos, com esquema, onde um agente único carregado com o manual inteiro corre o risco de cometer o mesmo tipo de erro que a Meta descreveu, trocar a regra de um sistema pela de outro.
A decisão que cabe nesta semana é uma lista. Pegue o agente que a sua equipe tem em produção ou em piloto, escreva cada decisão que ele toma por pedido e marque cada uma como roteamento ou raciocínio. Toda decisão de roteamento que hoje passa por uma chamada de modelo é candidata a virar código, com teste.
Quantas das chamadas de modelo que o seu agente faz por pedido decidem algo que um if decidiria?
De onde vem cada número
- Caso da Meta: "The Thin Orchestrator", de Plawan Rath, Akhil Jindal e Ashwini Verma, Engineering at Meta, publicado em 19/10/2026 e consultado em 20/10/2026. Todos os números do caso (1.300 linhas, mais de 20 fluxos, 14 subagentes, sete passos, mais de 25 arquivos de conhecimento com alguns milhares de tokens cada, de três a quatro dias para menos de uma hora, dois terços sem edição significativa, 70% a 80% e 10% a 20% do agente único alternativo) são declaração da empresa sobre o próprio sistema, sem verificação independente.
- Contrapontos: "Don't Build Multi-Agents", de Walden Yan, Cognition, 12/06/2025; "How we built our multi-agent research system", Anthropic, 13/06/2025 (4 e 15 vezes os tokens de um chat, 90,2% na avaliação interna de pesquisa).
- Contas nossas: as perto de 10 em cada 30 mudanças com edição significativa ou fora saem dos dois terços sem edição significativa declarados pela Meta; "perto de quatro vezes" é 15 dividido por 4, as duas aproximações da Anthropic contra a mesma base.
- Experiência da X-Apps: a rotina de publicação deste blog, descrita sem número.
- Validade: o relato descreve o sistema da Meta na data da publicação; a empresa diz que está ampliando o uso para novos domínios de pipeline.